Boa parte do que as empresas pedem para a inteligência artificial cabe numa decisão. Esse lead pede orçamento? Esse ticket é do financeiro ou do suporte? Esse comentário é ofensivo? Esse currículo tem experiência com Python? Para responder perguntas assim, a maioria dos sistemas ainda chama um modelo de linguagem enorme, espera ele escrever um parágrafo e depois extrai o "sim" ou o "não" de dentro do texto.
Em 15 de setembro de 2026, a TypeSafe AI lançou o Jev, um modelo que faz só a parte da decisão. Ele não escreve nada. Recebe a informação, recebe as perguntas e devolve probabilidades, no formato que o código já espera. A empresa chama isso de modelo "System One", e a ideia mexeu com o mercado: em menos de um mês, a TypeSafe saiu de uma rodada inicial de US$ 40 milhões para uma Série A de US$ 870 milhões.
Como engenheiro de software, o que me interessa no Jev é menos o hype e mais a mudança de arquitetura que ele propõe. Vale entender o que ele é, o que os números dizem de verdade e onde estão os limites.
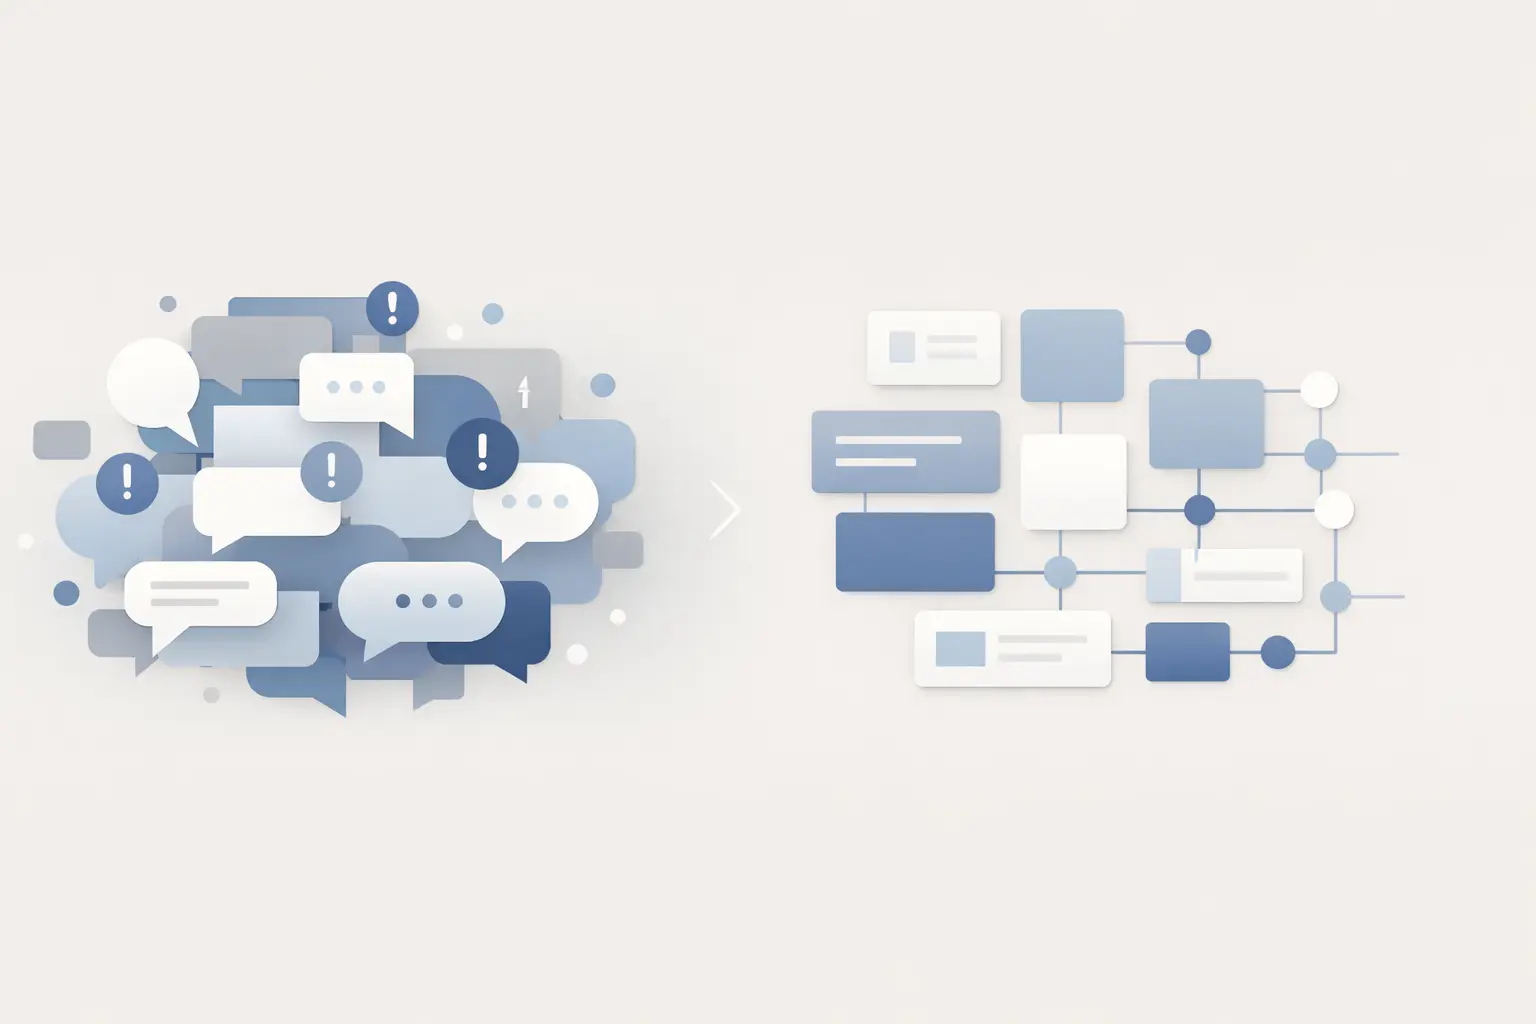
O mesmo lead, dois caminhos. O modelo de linguagem escreve a resposta palavra por palavra, e alguém ainda precisa interpretar o texto. O Jev devolve a probabilidade numa passada só.
O que é o Jev
O Jev é um modelo discriminativo: em vez de gerar texto, ele escolhe entre opções que você definiu. Na definição da Wikipedia), ele "não gera texto em linguagem natural". Você manda um state, que pode ser um texto, um objeto JSON ou uma lista, e um conjunto de perguntas tipadas sobre ele. A resposta é uma distribuição de probabilidade para cada pergunta.
Existem três tipos de pergunta:
- Noul é a pergunta de sim ou não. Devolve a probabilidade de a resposta ser "sim".
- Choice é a escolha entre até 255 opções sem ordem. Devolve a opção mais provável, a probabilidade de cada uma e uma confiança.
- Score é a posição numa escala de 2 a 10 níveis ordenados. Devolve a probabilidade de cada nível e a média ponderada entre eles.
Três perguntas sobre o mesmo lead, respondidas na mesma chamada. Cada pergunta é avaliada de forma independente, então uma quarta pergunta quase não muda o tempo de resposta.
Como a resposta só pode ser uma das opções que você definiu, ela nunca sai fora do formato. A TypeSafe chama isso de 0% de erro de tipo. O Flavio Copes, no guia mais completo sobre o modelo, faz a ressalva certa: essa garantia cobre a forma da resposta, e não se ela está correta.
Por que "System One"
O nome vem do psicólogo Daniel Kahneman, que dividiu o pensamento humano em dois sistemas. O System One é rápido e intuitivo: você reconhece um rosto ou percebe que um e-mail é golpe sem pensar. O System Two é lento e deliberado: você faz uma conta de cabeça ou escreve uma proposta.
A TypeSafe pegou a metáfora para dividir o trabalho da IA. Os modelos de raciocínio, que pensam passo a passo e escrevem, fazem o papel do System Two. O Jev faz o do System One, decidindo numa única passada, sem gerar uma palavra por vez. A Paper Compute lembra que "System One" é um rótulo da própria TypeSafe, e não uma categoria reconhecida pela indústria.
E o nome Jev? Vem do economista William Stanley Jevons e do paradoxo que leva o nome dele: quando um recurso fica mais barato de usar, o consumo total costuma crescer em vez de cair. A aposta da TypeSafe é que, com decisão barata, as empresas vão colocar IA em lugares onde hoje ela não compensa.
Como é uma chamada
A API recebe o state e as perguntas num único JSON. No exemplo abaixo, montado no formato documentado pelo Copes, o state é um lead que chegou pelo site:
{
  "model": "jev-latest",
  "state": {
    "mensagem": "Quero anunciar no Google para minha clínica em Limeira. Consegue me passar valores ainda hoje?"
  },
  "questions": {
    "pede_orcamento": {
      "type": "noul",
      "instructions": "A `mensagem` pede preço ou orçamento?"
    },
    "servico": {
      "type": "choice",
      "instructions": "Qual serviço a `mensagem` procura?",
      "criteria": {
        "software": "Site, sistema ou aplicativo",
        "trafego": "Anúncios, SEO ou redes sociais",
        "registro": "Registro de marca no INPI"
      }
    },
    "urgencia": {
      "type": "score",
      "instructions": "Qual a urgência do pedido?",
      "criteria": ["Pode esperar", "Para esta semana", "Para hoje"]
    }
  }
}
A resposta volta com um número para cada pergunta (por exemplo, 0,93 para "pede orçamento" e "tráfego" como serviço mais provável), e o seu código decide o que fazer. O modelo dá o julgamento; a regra de negócio continua com você.
Os números que a TypeSafe divulga
Segundo o guia do Copes, modelos de linguagem de ponta levaram de 3 a 329 segundos nas mesmas tarefas. A manchete do lançamento fala em 193,6 vezes mais rápido e 444,6 vezes mais barato, mas a própria TypeSafe apresenta esses números como o teto do que se vê em uso real. Em outras fontes, o multiplicador aparece como 100 vezes, como 40 a 200 vezes e como "até 200 vezes". A conta que importa é o custo de cada tarefa resolvida.
Há também uma ressalva de método. Comparar a latência de um modelo que escreve texto com a de um modelo que devolve alguns números favorece naturalmente o segundo. O ganho existe, mas a comparação justa é com outras formas de classificar, como modelos menores treinados para uma tarefa só.
RLCD: treinar o modelo para acertar a própria confiança
O Jev é treinado com RLCD, sigla em inglês para aprendizado por reforço para decisões calibradas. A recompensa depende de a probabilidade que o modelo declara bater com a taxa real de acerto. O glossário da Sanity resume bem a situação atual: o objetivo é público, o mecanismo não é.
O contraste é com o RLHF, o aprendizado por reforço com feedback humano que ajudou a criar o ChatGPT. Diogo Almeida, fundador da TypeSafe, trabalhou cerca de quatro anos na OpenAI justamente com RLHF. A tese dele, descrita pela MindStudio, é que o RLHF otimiza o modelo para soar certo para uma pessoa, enquanto o RLCD otimiza para estar certo. Os efeitos colaterais conhecidos do RLHF são a bajulação, a perda de variedade nas respostas e o excesso de confiança.
Desenho ilustrativo. Um modelo calibrado acompanha a diagonal: quando diz 80%, acerta perto de 80% das vezes. Um modelo com excesso de confiança fica abaixo dela, prometendo mais do que entrega.
Calibração é medida no conjunto das respostas, e o que ela entrega é saber quando dá para confiar no número. Precisão é outra conta. É a calibração que permite colocar regras no código.
A confiança vira regra de negócio
O Jev não se recusa a responder. Quem decide o que fazer com uma probabilidade baixa é a aplicação, com limiares definidos por você. A documentação usa 0,5 e 0,9 como exemplos.
Acima do limiar alto, o sistema age sozinho. Na faixa do meio, a decisão vai para uma pessoa ou para um modelo mais caro. Abaixo, vira "não".
Na prática, isso desenha uma arquitetura em camadas. O Jev faz a triagem barata de tudo; os casos duvidosos sobem para um modelo de raciocínio ou para um humano. É o System One filtrando o trabalho para o System Two.
O que a pesquisa independente encontrou
Até agora, a TypeSafe não publicou resultados em benchmarks públicos, e os testes de desempenho foram feitos pela própria equipe. Os primeiros estudos de fora são dois preprints, ainda sem revisão por pares.
O primeiro, Just Ask Jev, testou o modelo como detector de falhas de alinhamento em outros modelos de IA, como bajulação, jailbreak e alucinação, em 44 benchmarks. Com uma única pergunta genérica, o Jev chegou a um AUROC mediano de 0,886, sem treino específico, e custou 63 vezes menos que usar modelos de linguagem como juízes. A chamada mediana levou 0,31 segundo.
Ficar só com a metade das decisões em que o Jev estava mais confiante elevou a acurácia de 79,3% para 93,3%. É o uso dos limiares na prática.
O mesmo estudo traz uma ressalva sobre calibração: no agregado, o erro de calibração foi baixo (ECE de 0,047), mas, olhando benchmark por benchmark, a mediana foi de 0,168, pior que a de um modelo de referência. Os autores atribuem isso a diferenças na proporção de casos positivos de cada base. E o teste usou só a versão jev-1.13 e só textos em inglês.
O segundo, OpenJev-RLCD, não testa o Jev: tenta reproduzir a ideia do RLCD de forma aberta, num modelo pequeno de raciocínio, o Qwen3-1.7B. Numa tarefa de verificação de respostas de matemática, com no máximo 5% de erro, o método conseguiu decidir 81% dos itens, contra 19% do método de comparação. Os autores deixam claro que não afirmam nada sobre o algoritmo interno do Jev.
Quem está por trás e quanto dinheiro entrou
A TypeSafe AI foi fundada em 2024, em San Francisco, por Diogo Almeida, Erik Gafni e Sasha Sheng, e passou cerca de dois anos sem aparecer. O Jev chegou junto com uma rodada inicial de US$ 40 milhões liderada pela DCVC, que avaliou a empresa em US$ 200 milhões. Nas semanas seguintes, a imprensa noticiou conversas a uma avaliação de US$ 10 bilhões. A rodada que de fato fechou, em 9 de outubro, foi uma Série A de US$ 870 milhões a US$ 7,5 bilhões, liderada pela a16z, com Sequoia e DCVC.
Em 24 horas, 13% dos times pagantes do Vercel AI Gateway testaram o modelo, segundo a Value Add VC, que ressalva que isso mede integração num período gratuito, e não receita. A concorrência reagiu rápido: a OpenAI lançou uma Decisions API em 29 de setembro, e a Cloudflare lançou o Clef, um modelo aberto que aceita o mesmo formato de requisição, em 1º de outubro.
Onde ele já está sendo usado
Os casos documentados giram em torno de triagem, roteamento e verificação:
Recrutamento. A Metaview relatou buscas de candidatos cerca de 10 vezes mais rápidas. A Jack & Jill reduziu o custo por mil candidatos avaliados de US$ 0,755 para US$ 0,092. Os números são das próprias empresas.
Agentes de IA. A LangChain lançou uma integração que usa o Jev para decidir qual modelo atende cada pedido e para bloquear chamadas de ferramenta arriscadas antes que um agente as execute.
Rotulagem de dados. Um teste classificou 1.018 artigos científicos por US$ 0,08 no total.
Gateways de IA. Na arquitetura descrita pela Paper Compute, o Jev fornece o sinal de decisão e o gateway cuida de regras e registros. Nas palavras da empresa, "o Jev não é um gateway nem um roteador".
Para quem trabalha com marketing e vendas, o paralelo é direto: classificar leads que chegam pelo site, separar tickets por área, moderar comentários, decidir qual mensagem vai para qual etapa do funil. São decisões repetitivas, em volume, que hoje ou ficam com uma pessoa ou passam por um modelo caro demais para o tamanho da pergunta.
Os limites que ninguém deve ignorar
O Jev é fechado. Não há pesos para baixar, não há versão para rodar na sua máquina, não há artigo técnico explicando o modelo, e o tamanho dele não foi divulgado. Os números de desempenho vêm da TypeSafe ou de quem construiu os projetos de teste.
A própria TypeSafe mantém uma lista de pontos fracos, que chama de "jaggedness": leitura literal demais, matemática, datas, dupla negação, state poluído com informação irrelevante e conteúdo feito para enganar o modelo. E, claro, ele não escreve. Se a tarefa precisa de uma explicação, de um resumo ou de uma resposta ao cliente, o Jev resolve só a parte da decisão.
"Zero alucinação", expressão que aparece em textos de divulgação, também precisa ser lida com cuidado. O que o Jev garante é que a resposta respeita o formato. Uma resposta bem formatada ainda pode estar errada, e é por isso que a calibração e os limiares importam.
Há ainda a questão de dados. O Jev não treina com o que os clientes enviam, mas a retenção zero de dados só existe no plano enterprise. Para quem lida com dados pessoais, isso pesa na escolha.
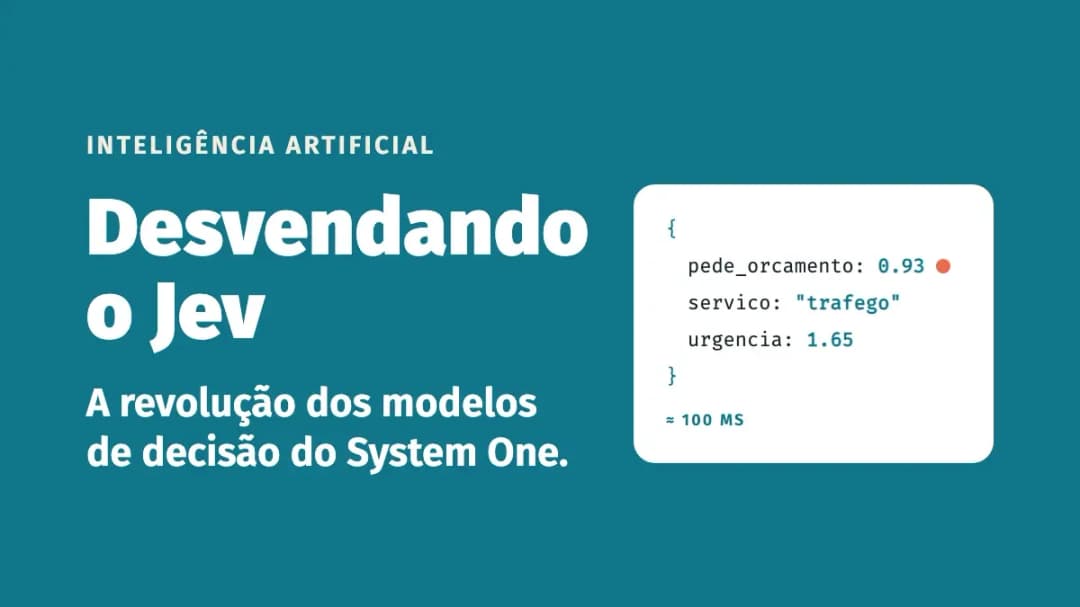
O Jev separa duas coisas que a gente vinha misturando: decidir e escrever. Para decisões repetitivas em volume, um modelo que devolve probabilidades calibradas em 100 milissegundos muda a conta de quanto custa colocar IA num processo. Mas ainda é um modelo fechado, de um mês de vida, com números quase todos autodeclarados. O caminho sensato é testar numa tarefa pequena, medir com os seus dados e definir os limiares antes de automatizar qualquer coisa. Se quiser entender onde isso se encaixa nos processos da sua empresa, a Oneck pode ajudar a mapear.
Fontes
- Flavio Copes, guia do Jev e de decisões tipadas (2026)
- Wikipedia, Jev (AI model))
- MindStudio, "Jev Explained: Typesafe AI's Non-Autoregressive System-1 Model" (2026)
- MindStudio, "RLCD vs RLHF: What Is Typesafe's Jev Model Actually Claiming?" (2026)
- Sanity, glossário: RLCD (Reinforcement Learning for Calibrated Decisions)
- Mehul Gupta, "What is RLCD in Jev AI?", Medium (2026)
- Paper Compute, Jev e AI Gateway (2026)
- LangChain, "Building a harness with Jev" (2026)
- Guo et al., "Just Ask Jev", arXiv 2609.29429 (2026), preprint
- Gao e Wang, "OpenJev-RLCD: A Working RLCD Implementation", arXiv 2609.38850 (2026), preprint
- Value Add VC, sobre as rodadas da TypeSafe AI (2026)
- SaaSCity, guia do Jev para startups (2026)